Naujoji „Arm C1“ branduolių šeima žymi reikšmingą pokytį mobiliųjų ir itin nešiojamųjų įrenginių ekosistemoje, pakeisdama pažįstamus „Cortex“ procesorius aiškesniu dėmesiu tvariam našumui ir efektyvumui. Ši karta pristatoma su „Lumex“ platforma ir turi aiškų tikslą: pagreitinti dirbtinį intelektą tiesiai įrenginyje nepakenkiant baterijos veikimo laikui ar temperatūrai.
Be pavadinimo pakeitimo, pasiūlyme derinama „Armv9.3-A“ architektūra , kruopščiai pertvarkyta atminties posistemė ir žymiai padidintos matricų skaičiavimo galimybės. Rezultatas – plataus masto našumo patobulinimai, mažesnės energijos sąnaudos ir parengtas planas išmaniesiems telefonams, planšetiniams kompiuteriams, nešiojamiesiems kompiuteriams ir nešiojamiesiems įrenginiams.
„Arm C1“ branduolių architektūra ir naujos savybės
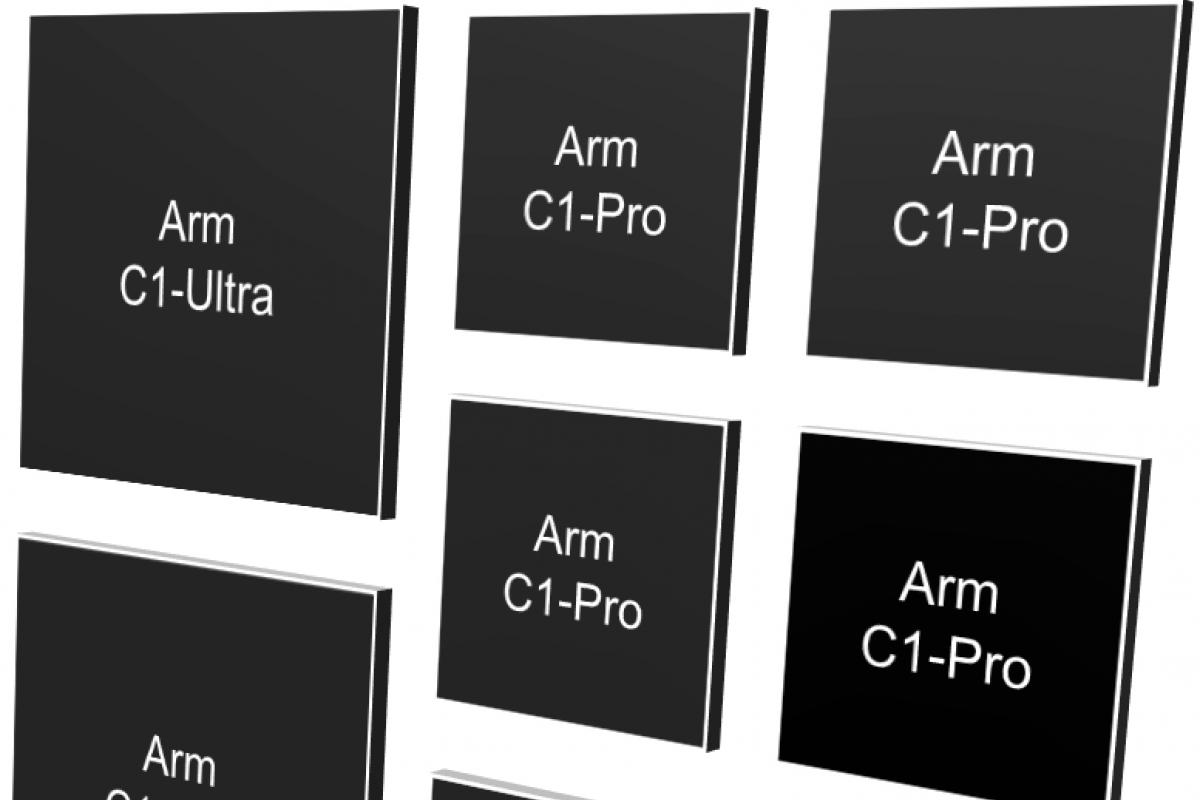
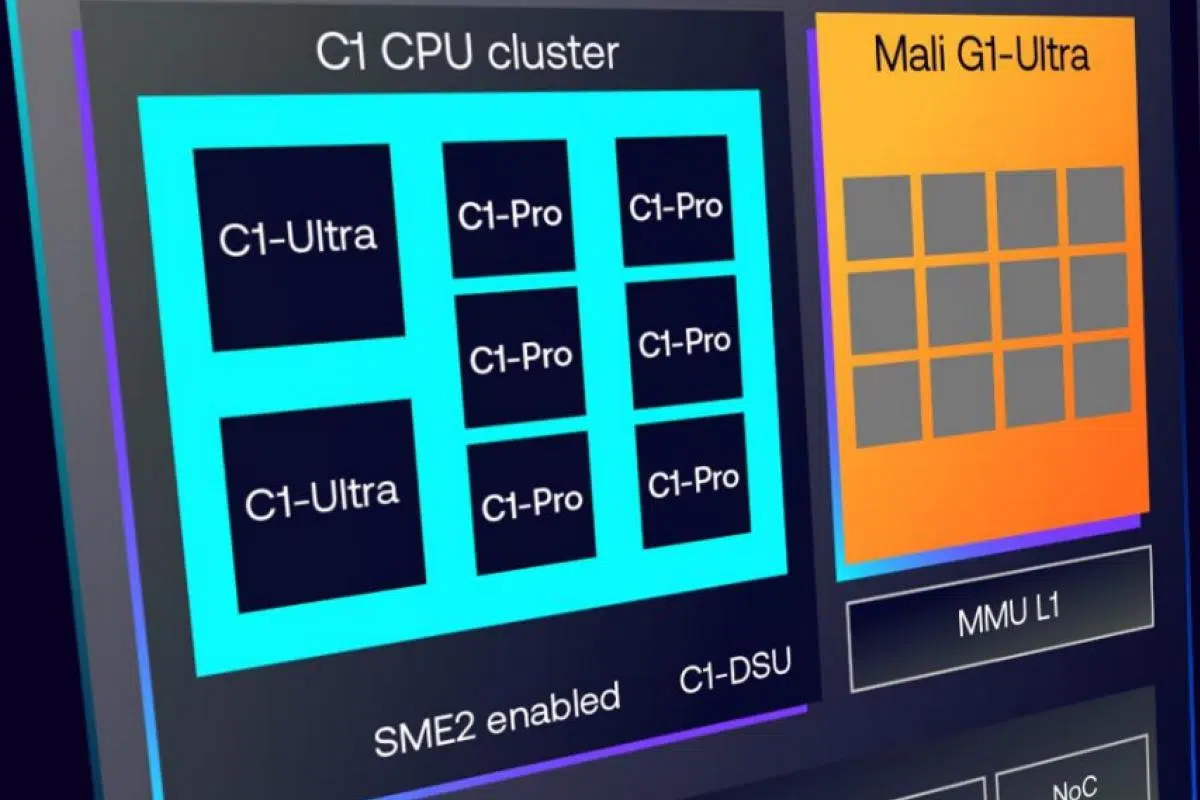
C1 serija suskirstyta į keturis variantus: C1-Ultra (maksimalus našumas), C1-Premium (didelis našumas mažesniame plote), C1-Pro (subalansuotas) ir C1-Nano (maksimalus efektyvumas). Kiekvienas gamintojas gali sujungti šiuos blokus į heterogeninius klasterius, kad sukurtų skirtingiems rinkos segmentams ir naudojimui pritaikytus SoC, kurių konfigūracija siekia iki 14 branduolių.
„Arm“ atnaujino tiek priekinę, tiek galinę dalis, įskaitant patobulinimus numatymo, talpyklos ir vykdymo ne pagal eilę srityse. Dėl naujo sujungimo ir efektyvesnės bendros talpyklos (intensyviai naudojant SLC ląsteles ), platforma siūlo vidutinį našumo padidėjimą apie 15 % kasdienio naudojimo metu, iki +30 % esant dideliems darbo krūviams ir iki 45 % pikų daugiabranduolėse aplinkose.
Atminties palaikymas vystomas kartu su LPDDR6 , siekiant sumažinti energijos suvartojimą ir delsą, išlaikant suderinamumą su LPDDR5X, kurio greitis siekia iki 9600 MT/s. Ši atminties bazė kartu su klasterio pertvarkymu sustiprina nuolatinį našumą ir reakciją esant šiluminiam slėgiui.
C1-Ultra: našumo riba
Būdamas aukščiausios klasės branduoliu, „C1-Ultra“ skirtas flagmaniniams SoC ir sudėtingoms užduotims, tokioms kaip skaičiavimo fotografija, dideli dirbtinio intelekto modeliai ir AAA mobiliųjų žaidimų kūrimas. Palyginti su „Cortex-X925“, „Arm“ teigia, kad vieno srauto našumas padidėja 25 % , o šis skaičius padeda padidinti bendrą našumą, kai klasteryje yra daugiau branduolių.
Priekinė dalis pagerina L1 instrukcijų pralaidumą ir numatymo tikslumą, o galinė dalis maždaug 25 % padidina ne eilės tvarkos vykdymo langą, todėl gali vienu metu apdoroti apie 2.000 instrukcijų . Be to, L1 duomenų dydis padvigubėja iki 128 KB, o L1 skaitymo greitis padidėja maždaug 33 %.
C1-Premium: didelis našumas mažesniame plote
Aukščiausios klasės įrenginiams, kuriems nereikia absoliutaus maksimalaus našumo, „C1-Premium“ architektūra labai artima „Ultra“, tačiau plotas sumažintas 35 % . Jis sukurtas siekiant subalansuoti našumą ir kainą, leidžiant sukurti kompaktiškesnius dizainus neprarandant įspūdingų specifikacijų.
C1-Pro: pusiausvyra ir daugiacentriai raumenys
Pagrindinių procesorių segmente „C1-Pro“ pakeičia „Cortex-A725“, pasiekdamas 11 % didesnį našumą išlaikant tas pačias energijos sąnaudas ir iki 26 % mažesnį efektyvumą, esant tokiam pačiam našumui . Žaidimų srityje „Arm“ nurodo apie 16 % šios klasės branduolių padidėjimą.
Svarbiausi patobulinimai yra galingesnė priekinė dalis (patobulinta statinė prognozė ir daug didesnis BTB ) ir galinė dalis su didesniu L1D pralaidumu ir mažesne L2 delsa, kai prognozė yra teisinga. Numatymo priemonė taip pat buvo suderinta taip, kad pagreitintų reagavimo laiką realiose situacijose.
C1-Nano: efektyvumas svarbiausia
Lengvoms užduotims ir itin ekonomiškoms išlaidoms atlikti „C1-Nano“ padidina efektyvumą apie 26 % , palyginti su savo pirmtaku (tuo pačiu plotas praktiškai nepakito, maždaug 2 % palyginti su „A520“). Numatymo ir paieškos etapai buvo atskirti, kad instrukcijos greičiau pasiektų L1 ir sutrumpėtų nepavykusių numatymų laukimo laikas.
Be to, optimizuotas vektoriaus apdorojimas , įrenginiai išjungiami, kai užstringa duomenų srautas, o srautas tarp L3 ir DRAM sumažėja (vidutiniškai apie 21 %, o esant tam tikroms apkrovoms – iki 39 %), o tai sumažina energijos suvartojimą ir pagerina reagavimą.
C1-DSU: Lankstūs klasteriai ir mažesnis suvartojimas
Naujasis C1-DSU koordinuoja branduolių sujungimą bendroje L3 talpykloje ir užpildo spragą su likusia SoC dalimi (RAM, GPU ir kt.). Palyginti su ankstesnėmis versijomis, ši konstrukcija sumažina tipines sistemos energijos sąnaudas apie 11 % , o atminties užimamą dalį – maždaug 7 %, nes, pasitelkiant tokius režimus kaip L3 Quick Nap, sumažinami nuostoliai, kai sistema nenaudojama.
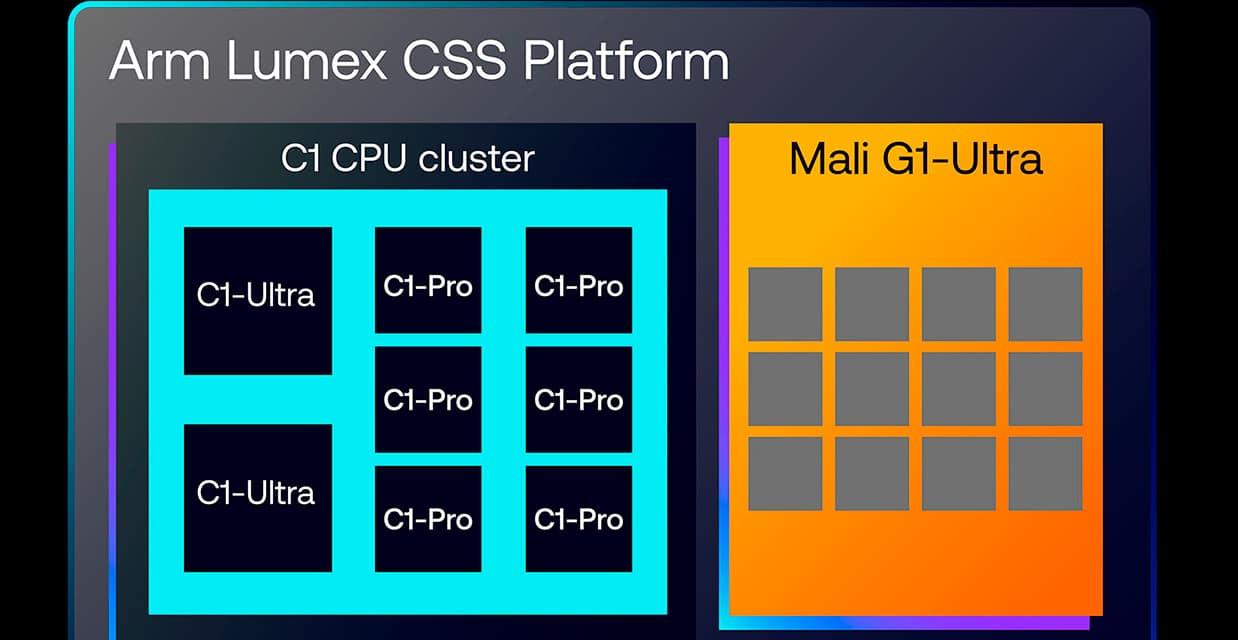
Kitas svarbus elementas yra SME2 akceleratorių integravimas kaip išorinių komponentų į branduolį: jų buvimas yra privalomas „C1-Ultra“ ir „C1-Premium“ sistemose, o „C1-Pro“ ir „C1-Nano“ – neprivalomas, priklausomai nuo gamintojo konstrukcijos. Bet kuris klasterio branduolys gali prie jų prisijungti, kai jie yra, todėl galima naudoti labai įvairius derinius (pavyzdžiui, 2 × C1-Ultra + 6 × C1-Pro su vienu ar dviem SME2 akceleratoriais arba kuklesnės konfigūracijos, kuriose derinami „Pro“ ir „Nano“).
„Lumex“ platformoje taip pat yra naujos kartos GPU. Nors šios naujienos daugiausia dėmesio skiria procesoriams, „ Mali G1“ siūlo maždaug 20 % geresnį grafikos našumą, dvigubai didesnį spindulių sekimo pralaidumą ir maždaug 9 % mažesnes energijos sąnaudas vienam kadrui, sustiprindamas paketą žaidimams ir dirbtinio intelekto darbo krūviams, kuriems pirmenybė teikiama GPU.
SME2 ir procesoriaus vaidmuo dirbtiniame intelekte
Didelį šuolį dirbtinio intelekto srityje žengia SME2 („Scalable Matrix Extension 2“) , kuris pagreitina matricų daugybą, kelis predikatus ir naujus duomenų tipus (įskaitant kompaktiškus tikslumus, pvz., 2b/4b), ir koordinuoja su SVE2, kad būtų galima atlikti pažangią vektorizaciją. Apibendrinant, „Arm“ praneša apie vidutinį 3,7 karto našumo pagerėjimą ir apie 27 % sumažėjusias energijos sąnaudas.
Praktiniuose pritaikymuose bendrovė pademonstravo 4,7 karto sumažėjusį kalbos atpažinimo („Whisper Base“) delsos laiką, 2,4–2,8 karto pagreitėjus teksto įgarsinimo režimu ir reikšmingą, beveik 5 kartus padidėjusį žetonų generavimą LLM (pvz., „Gemma 3“) . Veikiant centriniame procesoriuje, išvengiama perkėlimo į kitus greitintuvus, sutrumpėja laukimo laikas ir pagerėja reagavimas.
Mažiems arba interaktyviems darbo krūviams centrinis procesorius vėlgi užima pagrindinę vietą: naudojant SME2 daugelis kasdienių užduočių (vietinis vaizdo gerinimas, segmentavimas, klasifikavimas, kameros ar garso efektai) atliekamos greičiau, sunaudojant mažiau energijos ir be tinklo srauto. Padidėjus poreikiui, GPU arba išorinis NPU gali toliau perimti darbą, tačiau centrinis procesorius nebėra kliūtis.
Taip pat įtrauktas programinės įrangos palaikymas: yra integracija su „Linux“ ir „Android 16“ , optimizuotos įrankių grandinės ir bibliotekos („KleidiAI“) bei suderinamumas su tokiais varikliais kaip „Unity“ ir „Unreal Engine“ . Tai leis programoms ir žaidimams greičiau pritaikyti šiuos patobulinimus, kai tik pasirodys pirmieji komerciniai SoC.
„Lumex CSS“ platforma sujungia visus komponentus – C1 procesorių, „Mali G1“ grafikos plokštę, sujungimus ir atmintį – su gamybai paruoštais 3 nm dizainais , aparatinės įrangos telemetrija ir „Arm“ sistemos suderinamumu su LPDDR6. Tai leidžia partneriams paspartinti savo mobiliųjų ir nešiojamųjų kompiuterių projektus naudojant keičiamo dydžio klasterius iki 14 branduolių ir įrenginyje integruotas dirbtinio intelekto parinktis.
„Arm C1“ sujungia tvarų našumą , efektyvumą ir realų dirbtinio intelekto (DI) postūmį procesoriuje dėl SME2; jis siūlo C1-DSU lankstumą pritaikyti klasterius kiekvienam produktų asortimentui ir sudaro tvirtą pagrindą naujos kartos mobiliesiems ir nešiojamiesiems SoC, kurie siekia subalansuoti galią, autonomiją ir DI galimybes, ne visada priklausydami nuo debesies.